Appearance
移位与旋转:比特的搬家与轮回
上一课我们解开了负数之谜——补码。这一课回到指令本身,一口气拿下五个位操作指令:LSL、LSR、ASR、ROR、RRX。它们是位操作家族的收官之作,学完这一课,比特层面的"搬运工"就全部到齐了。
先看一个朴素的需求:想把 R0 里的数乘以 2,你打算怎么办?用第二课的 MUL?当然可以,但这像为了钉一颗钉子搬出整台冲床。硬件里藏着一条更快的捷径——把整条比特队列往左挪一格,右端空位补 0,数值就自动翻倍了。这一课就讲清楚这条捷径,以及它的四个兄弟。
1. 移位操作总览:同一个起点,四种命运
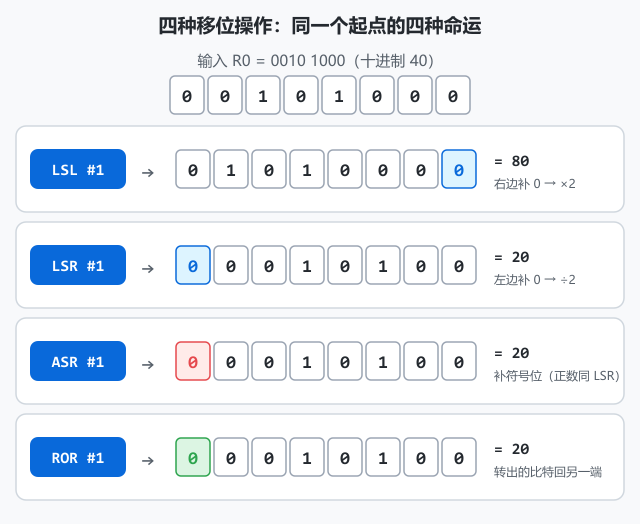
图 1 · 四种移位操作总览:输入同为 40,四种操作的空位填充规则各不相同
五条指令的区别全在一个问题上:移动之后,空出来的位置填什么?LSL 在右端补 0,LSR 在左端补 0,ASR 在左端补符号位,ROR 干脆不补——让掉出去的比特绕一圈回来。RRX 更特别,它把 CPSR 里的 C 标志也拉进旋转队伍。
另外,移位有两种写法。一种是独立指令,比如 lsl r0, r1, #2;另一种是"嵌入式位移",顺手挂在别的指令后面:
asm
    mov r1, r0, lsl #2   @ R1 = R0 左移 2 位,一条指令搞定
    add r2, r3, r4, lsl #1 @ R2 = R3 + (R4 × 2)
第二行那种写法是 ARM 的独门绝技:ALU 前面有个桶形移位器(barrel shifter),第二个源操作数进 ALU 之前可以先被移一程,不多花一个时钟周期。这一课后面都用独立指令演示,但读真实代码时两种形态都会遇到。
2. LSL 逻辑左移:右端补 0,移一位就是 ×2
LSL(Logical Shift Left,逻辑左移)的规则一句话:所有比特向左移动 n 位,右端空位补 0,左端被挤出去的比特丢弃。
拿 8 位值 0010 1000(40)连续左移两次:
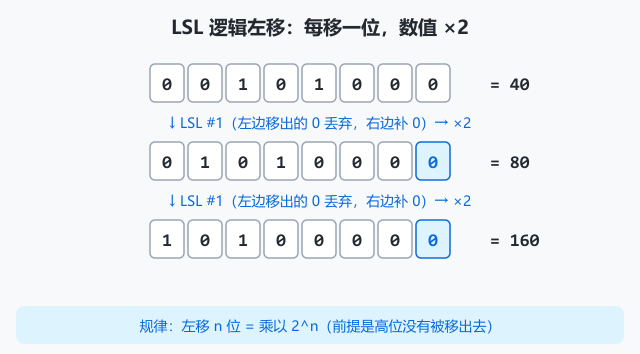
图 2 · LSL 逻辑左移:40 → 80 → 160,每移一位数值 ×2
40 变成 80,再变成 160——每左移一位,数值恰好翻倍。这不是巧合:二进制里每一位的权重都是右边的 2 倍,整体往左挪一格,等于每个比特都升了一级。推而广之,左移 n 位就是乘以
asm
    mov r0, #40        @ R0 = 40
    lsl r0, r0, #1     @ R0 = 80(40 × 2)
    lsl r0, r0, #2     @ R0 = 320(80 × 4)
易错点: "乘以 2"有个前提——高位没有被移出去。如果左移把一个 1 挤出了最高位,那一位就丢了,结果不再等于乘 2。顺带一提,最后被挤出的那一比特会被送进 C 标志,想检查移位有没有"丢东西",看 C 就知道。
在性能敏感的嵌入式代码里,凡是乘以 2 的幂的地方,编译器几乎都会把 MUL 换成 LSL——移位只要一个周期,乘法在低端核上可没这么便宜。
3. LSR 逻辑右移:左端补 0,移一位就是 ÷2
LSR(Logical Shift Right,逻辑右移)是 LSL 的镜像:所有比特向右移动 n 位,左端空位补 0,右端被挤出的比特丢弃。
asm
    mov r0, #40        @ R0 = 40
    lsr r0, r0, #1     @ R0 = 20(40 ÷ 2)
    lsr r0, r0, #1     @ R0 = 10(20 ÷ 2)
40 变 20、20 变 10,每右移一位就除以 2。右移 n 位就是除以
注: 右移做除法是"向下取整"的。比如 41 右移一位得 20,不会四舍五入成 21——被挤出的那个 1(余数)直接丢弃了。
不过,LSR 补 0 的朴素规则藏着一颗雷,下一节就引爆它。
4. ASR 算术右移:符号位亲自来填空
把上一课的补码知识请出来。32 位寄存器里的 -40 长这样:0xFFFFFFD8,用 8 位简化表示是 1101 1000。如果对负数用 LSR 右移一位,左端补 0,结果是 0110 1100——108。负数除以 2 算出一个巨大的正数,完全离谱。
问题就出在"补 0"上:负数的身份写在最高位那个 1 里,你补个 0,等于当场把符号擦掉了。
ASR(Arithmetic Shift Right,算术右移)就是为这件事生的:右移时,左端空位不补 0,而是补符号位——正数补 0,负数补 1。
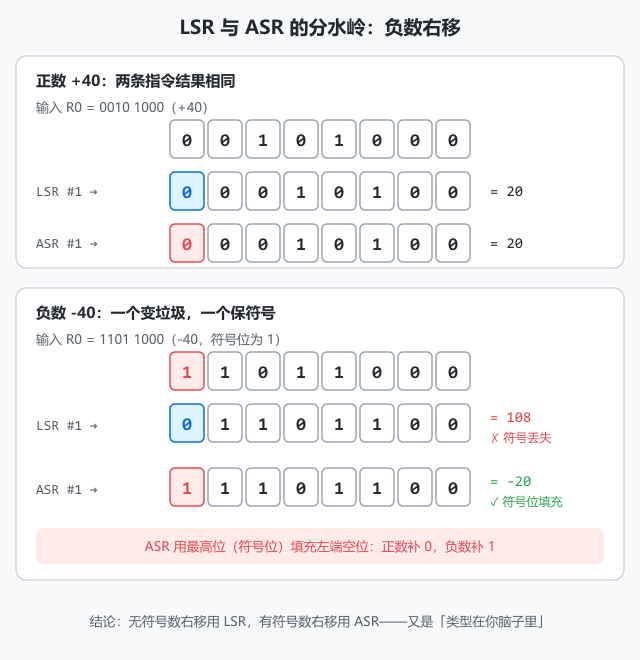
图 3 · LSR 与 ASR 的分水岭:负数右移时,只有 ASR 能保住符号
asm
    @ R0 = 0xFFFFFFD8(即 -40)
    asr r0, r0, #1     @ R0 = 0xFFFFFFEC(即 -20),符号安然无恙
    asr r0, r0, #1     @ R0 = 0xFFFFFFF6(即 -10)
-40 → -20 → -10,一路都是负数,数学上分毫不差。回头看,补码的设计在这里又一次显出威力:符号位填充能保住数值,靠的正是补码"高位 1 等价于负权重"的定义。
关键性质:无符号用 LSR,有符号用 ASR。 这还是第五课那句"CPU 不知道类型,类型在你脑子里"的延续——同一串比特,你想把它当有符号数除 2,就得选 ASR;选 LSR,CPU 也不会拦你,它只是默默补 0。
5. ROR 循环右移:比特的轮回
前面三条指令都会"丢比特":被挤出端点的比特直接消失。而 ROR(Rotate Right,循环右移)一个都舍不得丢——掉出右端的比特,会绕回左端重新入队。
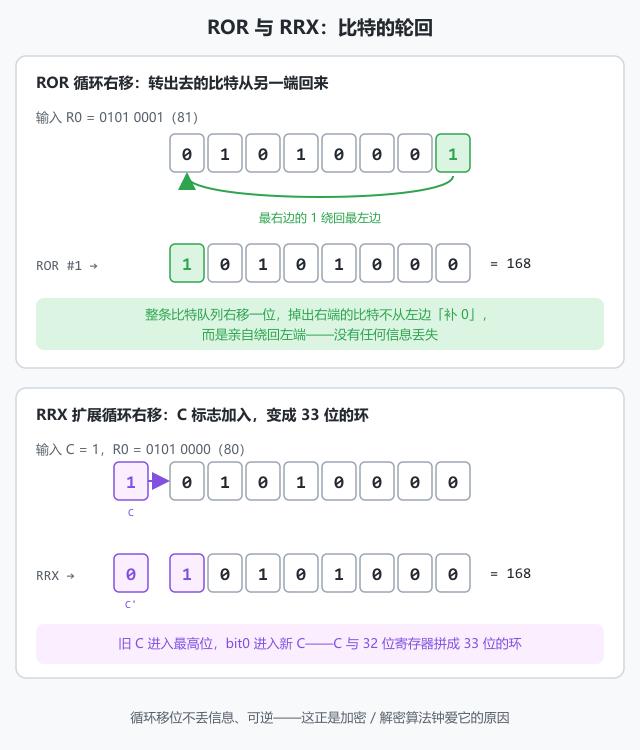
图 4 · ROR 与 RRX:比特的轮回,以及带上 C 标志的 33 位旋转
看上半部分的例子:0101 0001(81)循环右移一位,最右边的 1 不消失,而是绕到最左边,得到 1010 1000(168)。
asm
    @ R0 = 0x00000051(低 8 位是 0101 0001)
    ror r0, r0, #1     @ 最高位变成 1:0x80000028
32 位全量旋转时,0x51 右移一位会变成 0x80000028——那个绕回来的 1 直接坐上最高位,数值变得面目全非。这正是 ROR 的用途所在:它不追求"数值上的意义",追求的是比特图案的彻底重排,而且完全可逆——再循环右移 31 位就原样回来了。
注: 不丢信息、可逆,这两条性质让循环移位成了加密 / 解密算法的常客。很多加密例程(以及恶意软件的混淆代码)里都能看到成片的 ROR——逆向工程时见到它,基本就是在做比特级的打乱与还原。
6. RRX:带上 C 标志的 33 位旋转
RRX(Rotate Right with Extend,扩展循环右移)是五条指令里最特殊的一个:它不接受位移量参数,永远只移一位,而且把 CPSR 的 C 标志也拉进了环里。
图 4 下半部分演示了这个 33 位的环:旧 C 进入寄存器最高位,寄存器的 bit0 则进入新 C。相当于把"进位标志 + 32 位寄存器"拼成一条 33 位的队列,整体旋转一格。
asm
rrx r0, r0 @ C → R0 最高位;R0 的 bit0 → C它存在的意义是接力:做 64 位(甚至更长)数据的移位时,先用 LSR/ASR 移高 32 位(挤出的比特进 C),再用 RRX 移低 32 位,C 里那一比特就顺着滑进了低半部分的最高位——两半数据通过 C 标志无缝衔接。单看一条 RRX 平平无奇,放进多字移位的链条里,它是不可或缺的传送带。
7. 移几位?立即数或寄存器说了算
五条指令的位移量有两种给法:
asm
    lsl r0, r1, #5     @ 立即数:左移 5 位
    lsr r0, r1, r2     @ 寄存器:R2 里是几就移几位
立即数写死在指令里,速度快、一目了然;寄存器版则把位移量变成了运行时变量——循环里逐位处理数据、位移量由计算结果决定时,非它莫属。
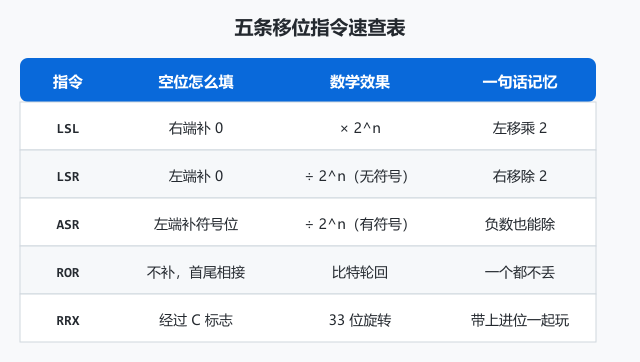
图 5 · 五条移位指令速查表
小结
这一课拿下的五条指令,区别只在"空位填什么":
- LSL:右端补 0,左移 n 位等于乘以
;高位被挤出就丢失,最后一滴进 C 标志 - LSR:左端补 0,右移 n 位等于无符号除以
,奇数向下取整 - ASR:左端补符号位,有符号数除以
的唯一正确选择,补码的第一次实战 - ROR:首尾相接的轮回,不丢信息、完全可逆,加密与逆向场景的老朋友
- RRX:不接受位移量,永远移一位,C 标志参与的 33 位旋转,多字移位的接力棒
- 位移量:立即数或寄存器两种给法;还有嵌入式位移写法
mov r1, r0, lsl #2,桶形移位器顺手完成,不多花周期
位操作家族到这里就齐活了——从第四课的逻辑运算、第五课的补码,到这一课的移位旋转,比特层面能玩的花样已经尽在掌握。下一课开始,我们将进入真正的"复杂指令"领域:分支与条件执行,让 CPU 不再只会一条道走到黑,而是学会做选择。下一课见。